使用方法
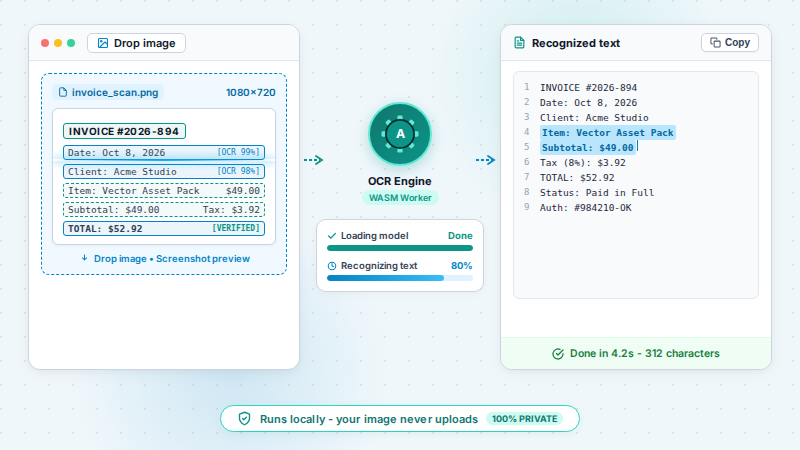
- 拖入图片(仅支持 PNG/JPG/WebP/BMP/GIF/PBM;TIFF/SVG 请先转格式)
- 点选一种或多种识别语言(20 种常用语言,可组合,如中英混排)
- 点击「开始识别」,按进度条等待两阶段完成;识别中可点「取消」随时中止(上次结果保留)
- 复制或下载识别文本
功能说明
- 基于 tesseract.js(Apache-2.0)
- 20 种常用语言可多选任意组合:英语 / 简体中文 / 繁體中文 / 日本語 / 한국어 / 德语 / 法语 / 西班牙语 / 意大利语 / 葡萄牙语 / 俄语 / 阿拉伯语 / 印地语 / 荷兰语 / 波兰语 / 土耳其语 / 越南语 / 泰语 / 乌克兰语 / 印尼语,多选以「+」组合交给引擎(如 eng+chi_sim 识别中英混排)
- 语言模型按需加载:选中某语言首次识别时才从 CDN 下载对应 traineddata,之后浏览器有缓存
- 进度分两阶段展示:加载引擎与语言模型(首次运行需从 CDN 下载,较慢)→ 识别文字;完成后显示耗时与字数摘要
- 识别中可取消:点击「取消」立即终止引擎,显示「已取消」中性提示(不报错),上次识别结果保留
- 浏览器本地识别
常见问题
- 中英混排的图片能一次识别吗? 能。同时点选「英语 + 简体中文」(eng+chi_sim)即可,多语言以「+」组合交给引擎一次跑完;多数在线 OCR 只能选一种语言,混排图片这里默认按组合处理。
- 支持哪些图片格式? PNG / JPG / WebP / BMP / GIF / PBM;TIFF 与 SVG 会被拒收并提示,请先转成 PNG 或 JPG 再拖入。
- 识别很慢,能中途取消吗? 能。点「取消」立即终止引擎,显示「已取消」中性提示(不算错误),上次识别结果原样保留。
- 免费吗?要登录吗?图片会上传吗? 免登录每日有免费额度;图片在浏览器本地识别、不会上传服务器。引擎与语言数据首次使用时从公共 CDN 下载(每个语言模型约 2–15 MB,之后浏览器缓存)。
- 这是什么意思?OCR 适合识别什么? OCR(光学字符识别)把图片里的像素文字转成可编辑的文本:清晰、正立、字号足够的截图、扫描件、文档照片效果最好;模糊、倾斜拍摄或艺术字体可能漏识或错字。
隐私
图片与识别结果不会上传服务器(引擎/语言数据从公共 CDN 加载)。